只有一篇文字稿,用codex生成很火的剪报风格视频
最近Opus 5.5生成视频好火,尤其那个剪报视频确实挺可爱的,也了解到它就是写代码来生成的视频。
出于好奇,用codex GPT-5.6Sol(不是GPT最新模型),也尝试了一下。好消息是,确实也可以哎😌~
把这个过程整理出来,可能你也需要。
一、一篇文字稿生成视频且能重复生成所需步骤
建立工程 → 整理脚本 → 确定模板 → 生成配音 → 制作场景 → 同步字幕 → 预览导出 → 固化复用流程
我这次尝试做第一个视频,需要确定视觉风格、声音、字幕和工程结构,遇上问题还要找方案解决,大概花了8个小时。但如果提前知道当前组合方案,可能只需要3、4个小时调试视频风格,如果使用固定模板化的skill,一句话等视频生成可能也就30分钟。
二、依赖工具
在使用codex基础上,还需要增加的工具。
1. Remotion和Remotion.skill
Remotion负责真正生成画面,包括:场景和动画、音视频时间轴、字幕显示、Studio实时预览、MP4渲染。
Remotion Skill只是指导Codex如何使用Remotion,不能代替Remotion程序。电脑上仍然需要Node.js、Remotion项目和相关依赖。
在codex搜Remotion skill,安上就行。
2. Qwen3-TTS模型
这个模型负责把字幕旁白变成你的克隆声音。就让codex下载安装开源Qwen3-TTS和克隆声线,保持之后的声音统一。
3.create_skill.skill
负责把视频制作规则形成一个通用模版skill,方便下次使用不用再重复上边的对话步骤。
三、从文章到视频的实现步骤
step1 把上边这些依赖工具,安装上。
step2 把文章整理成旁白和分镜
文章不能直接逐段搬进视频,需要先确定观众看完后应该理解什么,再把内容改成适合口述的旁白。
同时把旁白拆成场景,并为每个分镜定义:
这一段要解释什么,画面的主体是什么,主体要发生什么动作,需要出现哪些关键词。
如果对分镜没啥概念,想想之前看的漫画或者ppt,描述那个就行。当然也可以让大模型自己定。这里要要求整体时长控制在几分钟内,这样就可以调整每个scene的时长了,而不是最后压缩语速。
可验证的交付物:一份包含分集、旁白、场景目的和画面动作的脚本分镜文档。
step3 建立或选择视觉模板
可以详细按照这个框架告诉大模型想要的视觉样式
背景、字体、阴影、字幕和动画方式
当然,也可以丢给它一个期望样子的图片,让它自己来理解视觉样式。
一开始就制作完整视频。可以先做一个短的风格测试场景,确认后再扩展。
可验证的交付物:一个可以单独预览的模板测试Composition,以及可复用的模板组件。
step4 制作场景动画
根据分镜为每个场景编写Remotion组件。
验证交付物:可以在Studio中逐个播放的场景Composition,以及串联后的无字幕或初步版本。
step5 生成正式配音
上传一个想要的声线配音,让大模型使用Qwen3-TTS模型克隆出该声线,在让它使用该声音模版去念刚才生成的脚本字幕旁白。
验证交付物:每个场景的最终WAV文件,以及记录文本、时长和声音配置的清单。
step6 生成带音轨的视频
读取每段正式音频的真实时长,再设置对应场景的帧数。字幕必须来自最终旁白,逐句匹配声音。动画关键动作也要与旁白对应。
验证交付物:一个配音、字幕和动画基本同步的完整Studio预览版本。
注意检查场景衔接处是否自然,音轨与字幕是否对应的上等细节问题。
step7 输出视频文件
确认后输出H.264视频和AAC音频的MP4文件,再使用FFmpeg检查分辨率、帧率、时长和解码情况。(如果没有FFmpeg 大模型也会帮你安装好)
验证交付物: 最终MP4,以及通过技术检查的输出结果。
step8 固化流程
第一个视频完成后,把可复用部分与单期内容分开:
视觉模板保留在模板目录、声音保留为独立声线配置、每一期建立自己的场景和音频目录、把制作步骤、时长、隐私和验收规则写入Skill
下次只需要提供新文章,并调用同一个Skill。
以上看似很麻烦,但其实只是几句对话。先把依赖让codex给装好,然后按步骤给codex一些指令让它干活就可以了。
看一下成片片段
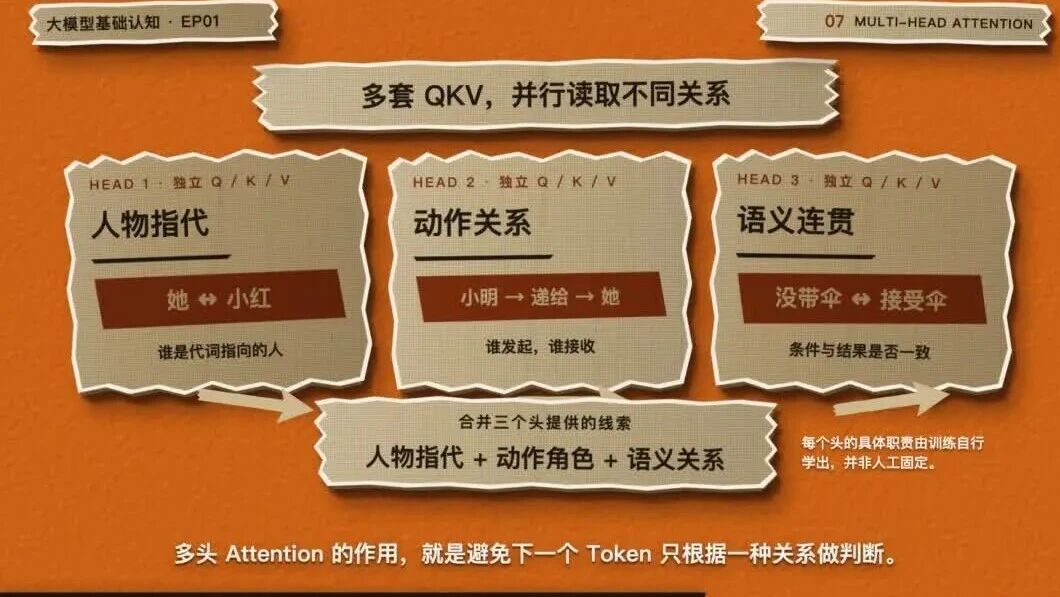
当然
相对于opus5.5,它不是一句话生成的视频,它本身好像也没那么bulingbuling的动效。
但是
动效可以用Remotion框架下,调试得更好
克隆声线原声,依然需要调用别的模型和工具
而且
有过很多次使用agent与大模型产生东西的经历,一定懂“可控”的重要性,尤其调试过程中,让对的部分留下,让错的部分走开,这种过程可控的可贵。
一点感想
一边是新模型、新技术快速更新,好像这个世界变得更美好了
一边是每天看到层出不穷的科技热点,喧嚣噪音好像也没让自己生活更美好,反而更聒噪,更有压迫
一边是资金和情绪让科技板块涨涨跌跌,疯狂心跳
到底变美好了吗?
金灿灿的阳光、五彩缤纷的秋天,就那一个真实画面,我觉得美好;
经过腌制并烤25分钟,香气四溢一口下去混合着酱汁和肉汁的肋排塞满口腔,即便是等了它25分钟,我也觉得美好;
跑5公里,过程是呼吸急促小腿很酸头很涨这样的痛苦,跑了几次速度也不怎么提升,也依然惧怕跑步,可跑后的2分钟爽感让我觉得美好;
忽然发现一个语音模型就可以复制我的声线,让我不用一遍遍错了重来地录音,终于可以试着弄弄视频,我同样觉得美好……
很多美好,就是这些微不足道的一点点……它和生产力和效率没关系,它可能只和自己那一点点的满足感有关系……
这么长的文章都看完了,可能你也蛮喜欢我的,记得关注哦~
中国美术馆在展 尼古拉·费欣 《菜娥——卷心菜收获季》
#视频生成 #GPT-5.6 #Opus5.5