复盘vibe coding,做了一个skill来帮我
最近发布的AI分析产品是与chatGPT对话搓出来的,简单总结一下。
① vibe coding对话原则
让大模型先给方案,再执行。方案是需要人判断的,中间的问题细节需要让它修改调整。人确认后,它再写代码。
不懂就问。它反馈的内容如果是技术语言,不太看得懂就直接问,比如“如何理解……”,搞懂了再判断这个方案是否合理。不要担心在同一对话中生成问题分枝,通常大模型上下文窗口挺大的,只要不是问题一环套一环地逐渐开发主线,一句话就能拉回来继续开发。
说人话就行。如果本身就是开发人员,用技术语言当然更精准。但如果不太懂技术语言,就可以白话沟通,避免使用错误的技术语言让它产生更多误解。
② 我与chatGPTvibe coding是如何对话的
首先,说出理想中的产品结果。比如 我想做个分析AI工具,它要有1、2、3功能,要有A、B、C页面,最终的成品报告要含有 一、二、三章节。
这里的重要程度:功能>页面>样式,即最想让它来实现的目标最重要,可以给大模型一定自由度按照目标来设计规划。这一步弄完,大概率会有一个demo样子出来了,而这仅是开始。
其次,要说清楚每个功能希望它承担的职责。比如 我的首页要有几个点击按钮,分别对应的是不同报告类型的选择,要有上传文件的按钮,文件个数上限等,即职责边界和限制需要说清楚。
再次,拆分功能是由LLM和规则代码如何配合实现。明确有几个调用LLM的环节,比如在用户输入文字的时候,要LLM判断用户上传的文字是否是有效,是否是分析问题,如果不是则需要返回重填。这里LLM来判断,而重新填写这个提醒动作是规则代码触发。
然后,是最重的一项工作,后端逻辑和信息流确定。在把LLM要负责的内容确定好之后,就好像在几个功能节点安排了各自大脑,大脑负责接收信息,按照它的执行设定完成信息的加工,然后按照规定数据格式输出信息。为保证这些信息的准确,不在信息传递中产生幻觉,在我的项目中会使用"证据"来串联,并且有一份对证据审核达标的标准,根据标准审核校验,这些判断是规则代码实现的。
最后,产品核心逻辑都搞定了,是产品测试和发布上线。
所有这些还仅是开发产品的过程,这中间依然穿插着很多不可抗力的外部依赖,比如域名注册、购买云服务、微信授权登录、支付渠道开通等等。遇上问题就直接回到vibe coding开发原则“问”。
上述过程,看似还很抽象,与我的AI分析产品问了什么问题离得还有点远。那么,来简单总结一下主要的问题框架。
③ 梳理开发对话主题
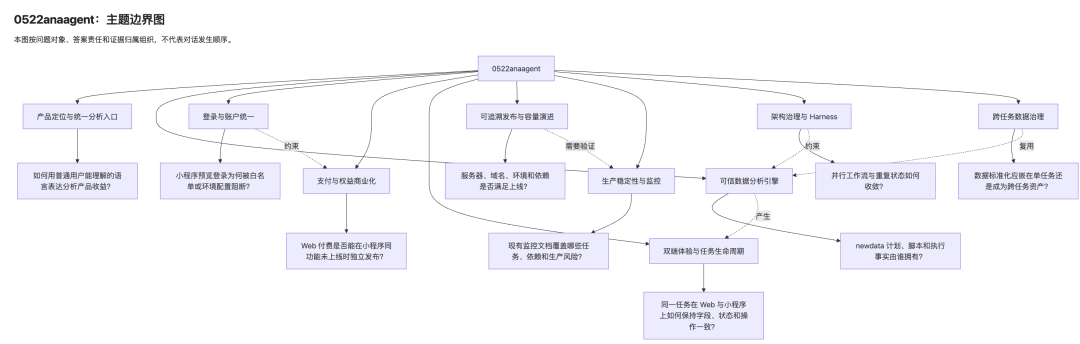
产品定位与统一分析入口:界定产品解决什么问题、服务谁以及如何对外表达;不承担底层执行合同。
可信数据分析引擎:负责数据语义、分析计划、脚本执行、证据与报告之间的可追溯主链;不承担账户和支付。
登录与账户统一:负责手机号、微信、小程序预览和跨端账户事实;不处理权益结算。
支付与权益商业化:负责订单、支付、次数权益、扣减与返还;不定义分析内容。
双端体验与任务生命周期:负责 Web 与小程序共享任务、进度、报告、追问和恢复语义。
可追溯发布与容量演进:负责构建、Manifest、镜像、部署、回滚和容量拆分;不等同当前生产健康。
生产稳定性与监控:负责依赖、采集器、磁盘和行为探针;不替代产品任务状态。
架构治理与 Harness:负责单一主链、职责所有权和 Harness 适配边界;不新增第二套执行框架。
跨任务数据治理:负责跨任务数据标准化与复用方向;不属于单任务分析主链。
④ 为了更好vibe coding,做了一个项目对话管理skill
回顾vibe coding到底聊了什么,在整理成复盘文档,确实也是很费劲的事,问题在于:
同一个项目分散在多个AI助手、多个对话task、多轮对话中
只记得最终结果,不记得决策过程
之前聊过,但还没有执行的优化分支容易忘记
对话里提到过很多文档和代码,后来很难找到
每次重新总结都要从头阅读,速度慢且结论容易变化
如果是多个项目,更难找到原始对话
于是我又写了一个skill,帮我做长期的vibe coding管理,它可以把这些零散对话恢复成:
项目 → 主题 → 问题分支 → 答案和决策 → 产生的文件 → 当前状态 → 未完成内容
最终保存在 Obsidian 中,成为可以长期维护的项目知识库。
为什么用obsidian,可以看我之前的一篇文章Obsidian+iCloud+Claude 文件管理神器了
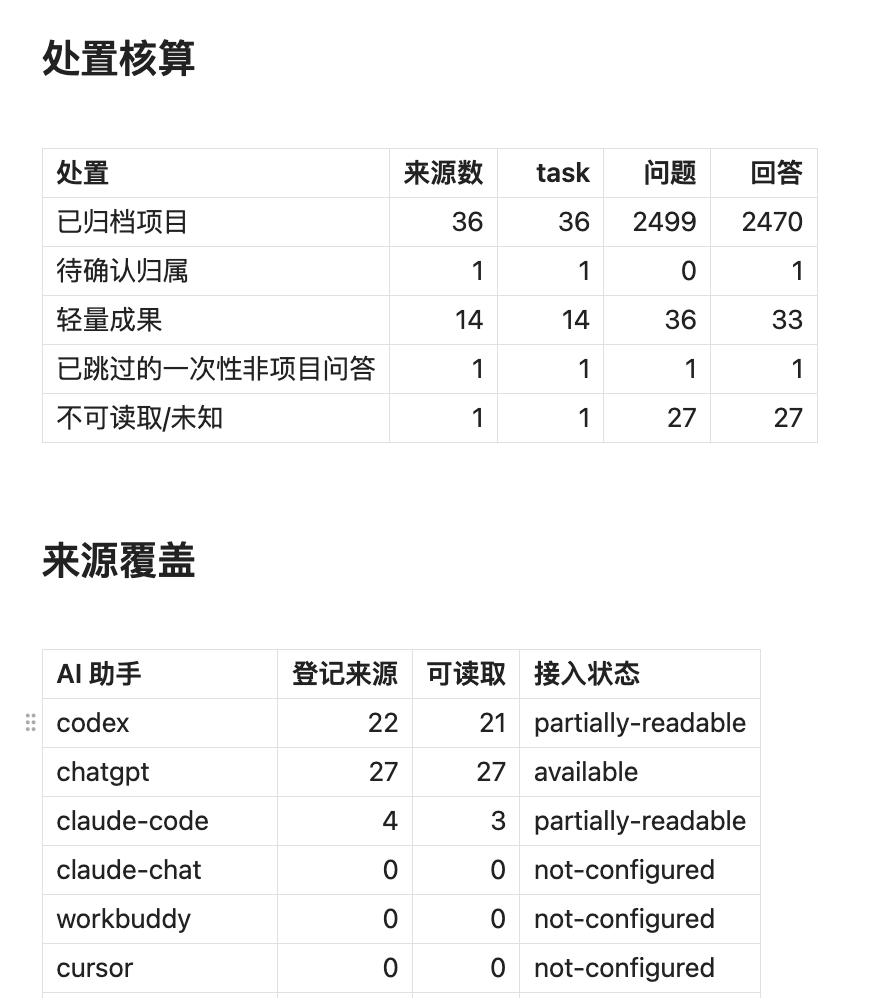
skill自动根据所有AI助手对话来总结,不用逐一告诉它每个项目。它统计执行完毕之后,会形成一个项目索引,包含所有对话的统计概览,如:
同时也有每个项目的详细复盘情况,存在obsidian里,大概长这样:
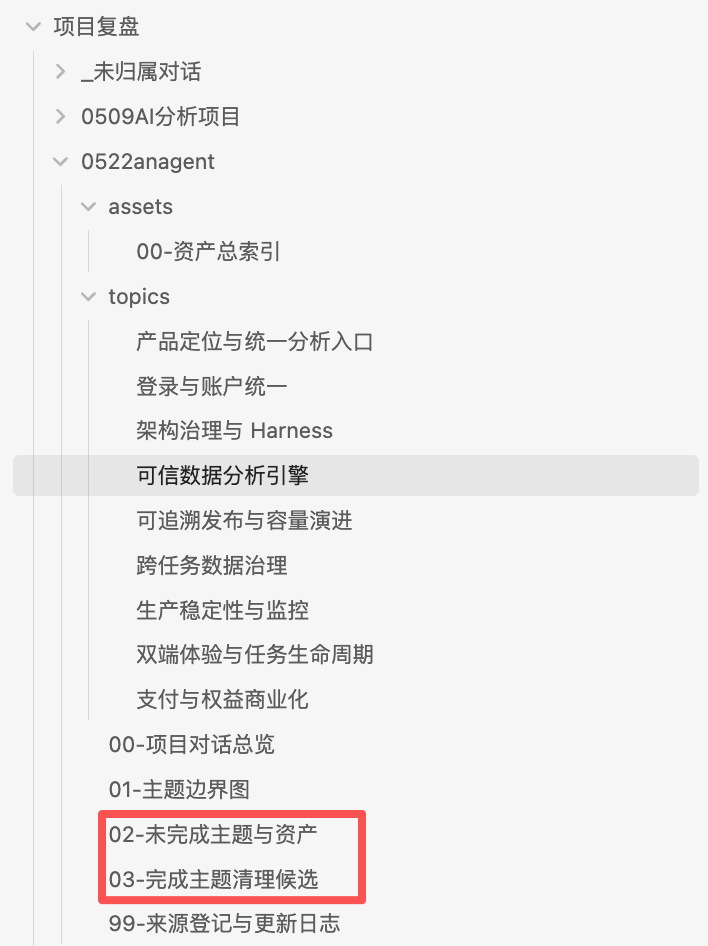
可以看到,项目总结里有未完成的部分,和完成待清理的部分,都是可以让大模型后续优化,或清理无用中间文件的后续动作依据。
那么一个核心问题:把这些项目合并起来的标准是什么?
问题针对的对象是否相同;
希望得到的结果是否相同;
最终由哪项能力、文档或代码负责;
不同问题之间是依赖、约束、验证还是反馈关系。
整体是根据问题网络总结,并非问题的先后顺序机械排列。
这个skill叫【project-conversation-archive.skill】已开源,有需要的朋友请👉🏻 https://github.com/yamaz49/project-conversation-archive
都看了这么久了,可能你也很喜欢我,记得关注哦~
AI分析工具戳 anaagent AI分析